换一种语言配音
录制或生成翻译后的配音,说话人的口型就会跟着新台词走,不再对着原来的台词,配音也就不再一看就是后配的。
AI 对口型
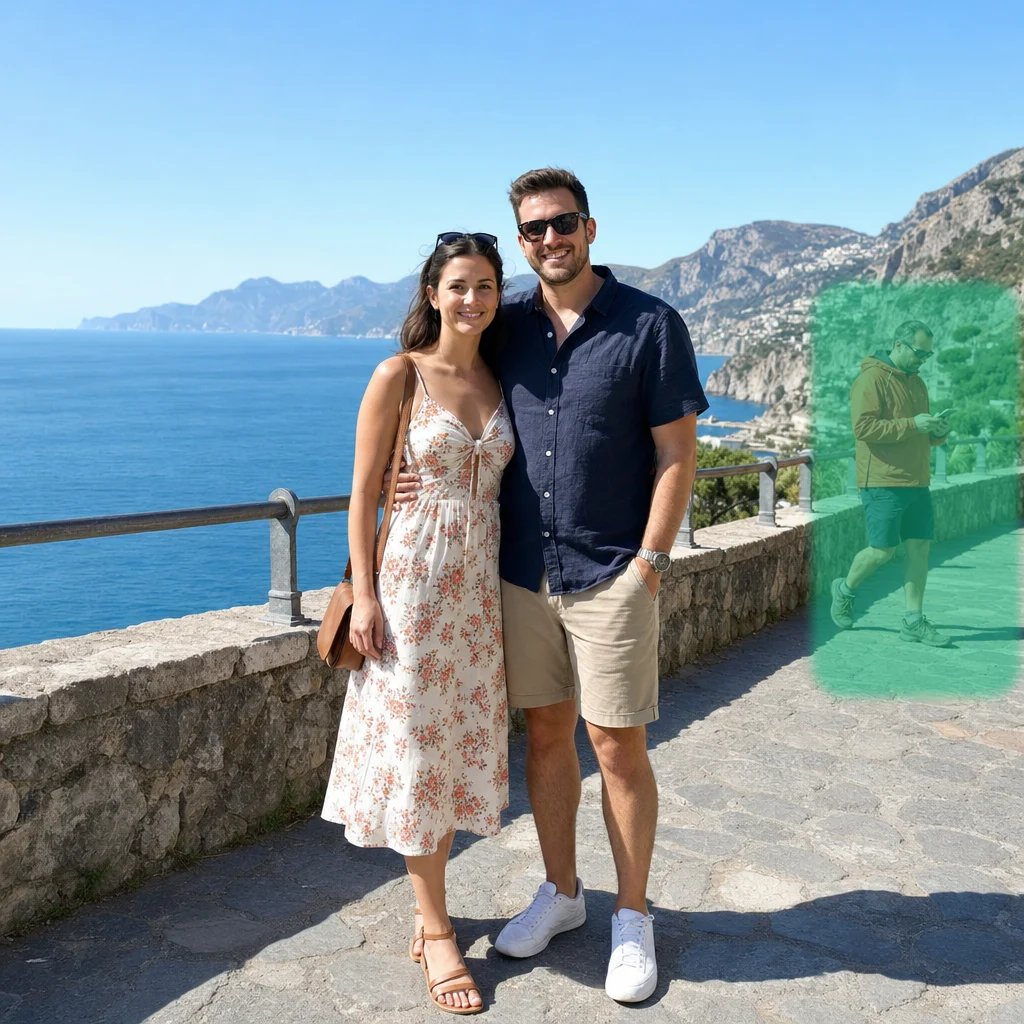
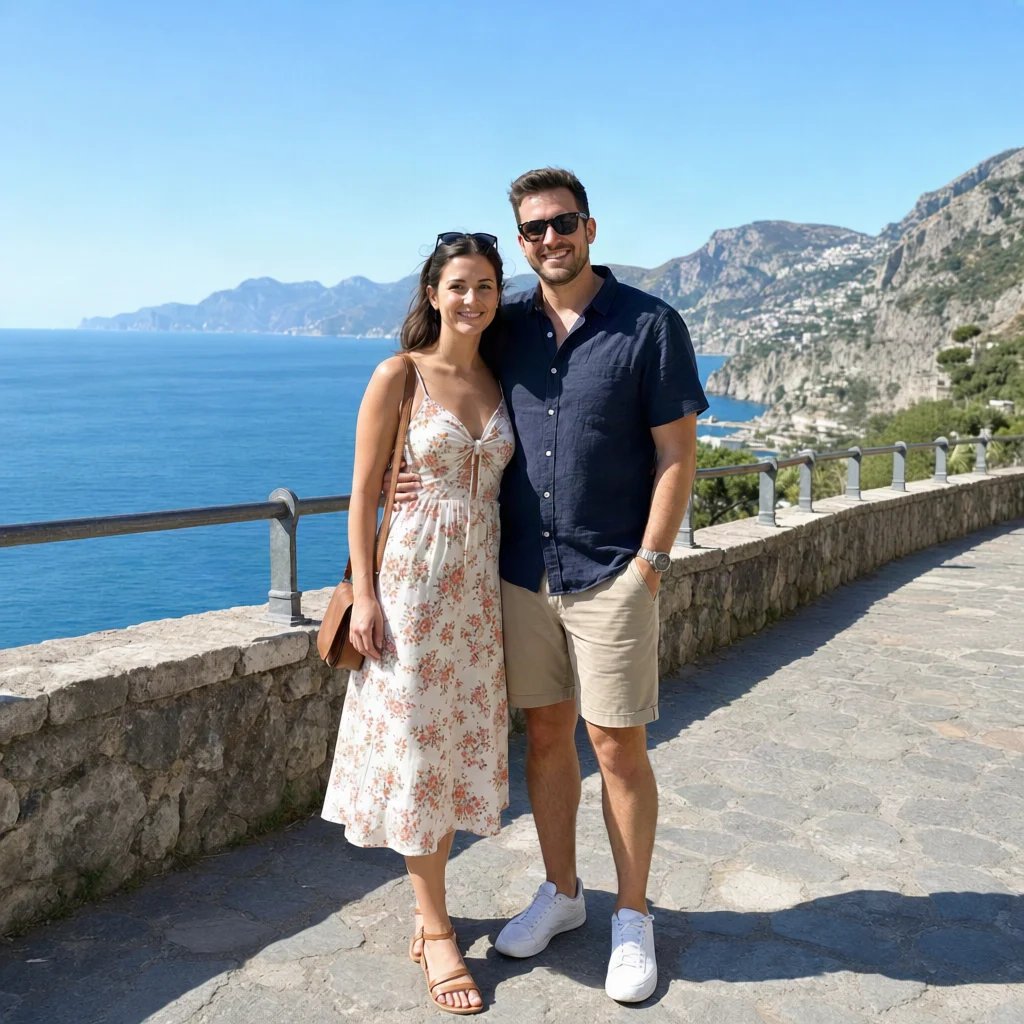
上传一段视频和你想让它说的音频。说话人的嘴部会按每一个字重新绘制,面部、背景和运镜都保持拍摄时的样子。最难处理的镜头选 Sync 3,想少花一些就选 Lipsync 2 Pro。
将现有视频中的口型重新对齐到新的音频,面部其余部分和场景保持不变。适用于实拍、动画和 AI 生成的画面,支持侧脸、特写、部分遮挡的面部以及多人镜头。
按成片秒数计费,不足一秒按一秒计。视频时长与你的音频一致,所以添加音频后,下方价格会显示确切总额。
对好口型的视频会在一个可以随时回来的会话中打开,可以直接下载,也可以带进另一个工具继续用。
使用方法
添加一段最长 60 秒、说话人面部清晰可见的片段。实拍、动画和 AI 生成的画面都可以。
添加说话人要说的人声音轨,时长 1 到 60 秒:可以是翻译后的配音、重新录的台词,或 AI 生成的语音。然后选择一个模型。
成片时长与你的音频一致,会在属于你的会话中打开,可以直接下载,也可以带进下一步编辑。
适用场景
录制或生成翻译后的配音,说话人的口型就会跟着新台词走,不再对着原来的台词,配音也就不再一看就是后配的。
产品名说错了、价格改了、某个词说得磕巴:把改好的台词重新录一遍,再对到你已经拍好的那条镜头上。
出镜人只拍一条,之后只换旁白,就能为不同的优惠、市场或受众做出不同版本。
给 AI 生成或动画里的角色配上声音。两个模型除了实拍,也都支持 AI 生成的画面和动画。
你的视频会怎样变化
嘴唇和下颌会按新音频重新绘制。面部其余部分、背景、光线和运镜都保持拍摄时的样子,成片播放的是你的新音频。
成片的时长总是和你的音频完全一致。如果音频比片段长,片段会先正放、再倒放,如此往复,直到音频结束。如果音频更短,片段会在音频停下的地方截断。无论哪种情况,都按音频的时长计费。
Sync 3 是默认模型,专门应对难处理的镜头:侧脸角度、特写和部分被遮挡的面部。Lipsync 2 Pro 每秒价格更低,会保留牙齿、胡须等细节,画面里有好几个人时,会跟随正在说话的那一个。
对口型按成片的秒数计费,短片段就只花短片段该花的钱。每个套餐都包含积分,可以用在 YouArt 的任何其他工具上。
适合爱好者和探索者
适合专业人士
适合高级用户和团队
适合团队和工作室
常见问题
不止一个片段
这个页面一次只跑一个步骤。打开工作流编辑器,可以在同一个工作流里先生成配音再对口型,给你生成的片段加上对口型,或者让一批视频走同样的步骤。